Informe de laboratorio · Serie Visualización · Markdex

Visualización avanzada de datos con Python: parámetros y resultados

Registro de un ensayo controlado: 40 figuras generadas desde el mismo conjunto de datos con Matplotlib y Seaborn, seis parámetros de configuración modificados y cuatro variables medidas antes y después del ajuste. Tiempos, contraste, peso de archivo y legibilidad en proyección quedaron documentados con el mismo equipo y la misma pantalla.

Figuras analizadas
40
Lectores en proyección
12
Resolución de salida
300 dpi
Tiempo de generación
−56 %

Los seis parámetros que se ajustaron

Cada parámetro se cambió por separado para poder atribuir el efecto a una causa concreta. El conjunto de datos fue siempre el mismo: 12.400 filas y 9 variables de ventas, con los mismos filtros y las mismas agregaciones en las dos configuraciones. La configuración base se ejecutó con los valores por defecto de la librería, sin ninguna personalización previa.

El detalle completo de la metodología y del resto de ensayos de la serie está en el diario técnico de Markdex, donde cada prueba se publica con su script y sus mediciones.

Los parámetros se agruparon en tres familias: los que afectan al archivo final (resolución y formato), los que afectan a la composición (tamaño y tipografía) y los que afectan al proceso de trabajo (backend de render y paleta). Cambiar solo la resolución, sin tocar tipografía, no corrigió el problema de lectura en proyección; el efecto apareció al combinar ambos ajustes.

Para ver cómo se aplican estos mismos valores en un cuaderno real de clasificación, revisa el análisis predictivo con Python, que usa la misma estructura de exportación.

Resolución: dpi=150 y dpi=300

La densidad de puntos por pulgada define el detalle del archivo exportado. A 150 dpi el PNG era suficiente para pantalla; a 300 dpi el texto de 9 pt siguió nítido en impresión A4 y en proyector a 4 metros. Por debajo de 100 dpi las etiquetas numéricas perdieron definición al reescalar.

Ver coste de estas configuraciones
Tamaño: figsize=(8.27, 11.69)

La figura se dimensiona en pulgadas, no en píxeles. Fijar el lienzo al tamaño final del documento evita reescalados y mantiene la proporción de los ejes. Con el lienzo por defecto, el texto crecía o menguaba según el visor y la lectura dependía del ancho de pantalla.

Ver trabajos con este formato

Backend de render: Agg frente a interactivo

Se comparó el backend Agg, sin interfaz gráfica y apto para servidores, con el backend interactivo de Jupyter. Agg redujo el tiempo de exportación del lote de 40 figuras de 3 min 10 s a 1 min 24 s y eliminó los bloqueos al ejecutar el cuaderno en una máquina sin pantalla.

Volver a la portada de Markdex

Paleta y contraste mínimo

Se sustituyó la paleta cíclica por defecto por Okabe–Ito, de 8 colores legibles para daltonismo, y se fijó un contraste mínimo de 3:1 entre cada serie y el fondo. Además se limitó a 6 el número de series visibles por gráfico; el resto pasó a una tabla anexa.

Ver el resto de ensayos

Tipografía con jerarquía fija

Título a 11 pt, etiquetas de eje a 9 pt y anotaciones a 8 pt. Bajar el cuerpo de 10 a 9 pt no empeoró la lectura porque el tamaño final de la figura creció en la misma proporción. La regla que se conservó: ningún texto impreso por debajo de 8 pt.

Aplicación en un caso predictivo

Formato y exportación

PNG para informes, SVG para documentos editables y HTML para paneles interactivos. El informe de prueba pasó de 38 MB, con diez gráficos incrustados en HTML, a 11 MB en PNG optimizado con bbox_inches='tight' y pad_inches=0.05.

Consultar tarifas de taller

Qué se midió y en qué condiciones

El banco de pruebas fue un cuaderno de Jupyter ejecutado sobre Python 3.11, Matplotlib 3.8.2 y Seaborn 0.13.1. Cada figura se generó dos veces, con configuración base y con configuración ajustada, desde el mismo DataFrame de 12.400 filas y sin modificar filtros ni agregaciones. Las variables dependientes fueron cuatro: tiempo de generación por figura, peso del archivo resultante, contraste mínimo medido entre trazo y fondo, y número de errores detectados en la revisión manual posterior.

El contraste se midió con un medidor de luminancia sobre captura de pantalla calibrada, no a ojo. Cada figura se evaluó dos veces en días distintos para descartar variación del observador, y las diferencias superiores a 0,2 puntos en la escala de contraste se revisaron de nuevo. El procedimiento completo de captura de datos está descrito en el diario técnico.

Hipótesis: el fallo no aparece en pantalla, aparece al proyectar

La hipótesis de partida era que los valores por defecto —6,4 × 4,8 pulgadas, 100 dpi y tipografía de 10 pt— funcionan en un monitor de 24 pulgadas a 60 cm, pero se quedan cortos en proyección o en impresión. Para verificarlo, doce personas revisaron las mismas 20 figuras a 4 metros del proyector y anotaron qué etiquetas no podían leer. Con la configuración base, solo 4 de 12 identificaron correctamente los valores del eje Y.

Ajustes aplicados

  • Resolución de exportación de 100 dpi a 300 dpi; versión de pantalla a 150 dpi.
  • Jerarquía tipográfica fija: título 11 pt, ejes 9 pt, anotaciones 8 pt.
  • Trazo de datos de 1,0 a 1,8 pt; rejilla de 0,6 a 0,4 pt en color neutro.
  • Paleta Okabe–Ito con un máximo de 6 series visibles por gráfico.
  • Exportación con bbox_inches='tight', pad_inches=0.05 y metadatos eliminados.
  • Ejecución por lotes con backend Agg en lugar del backend interactivo.
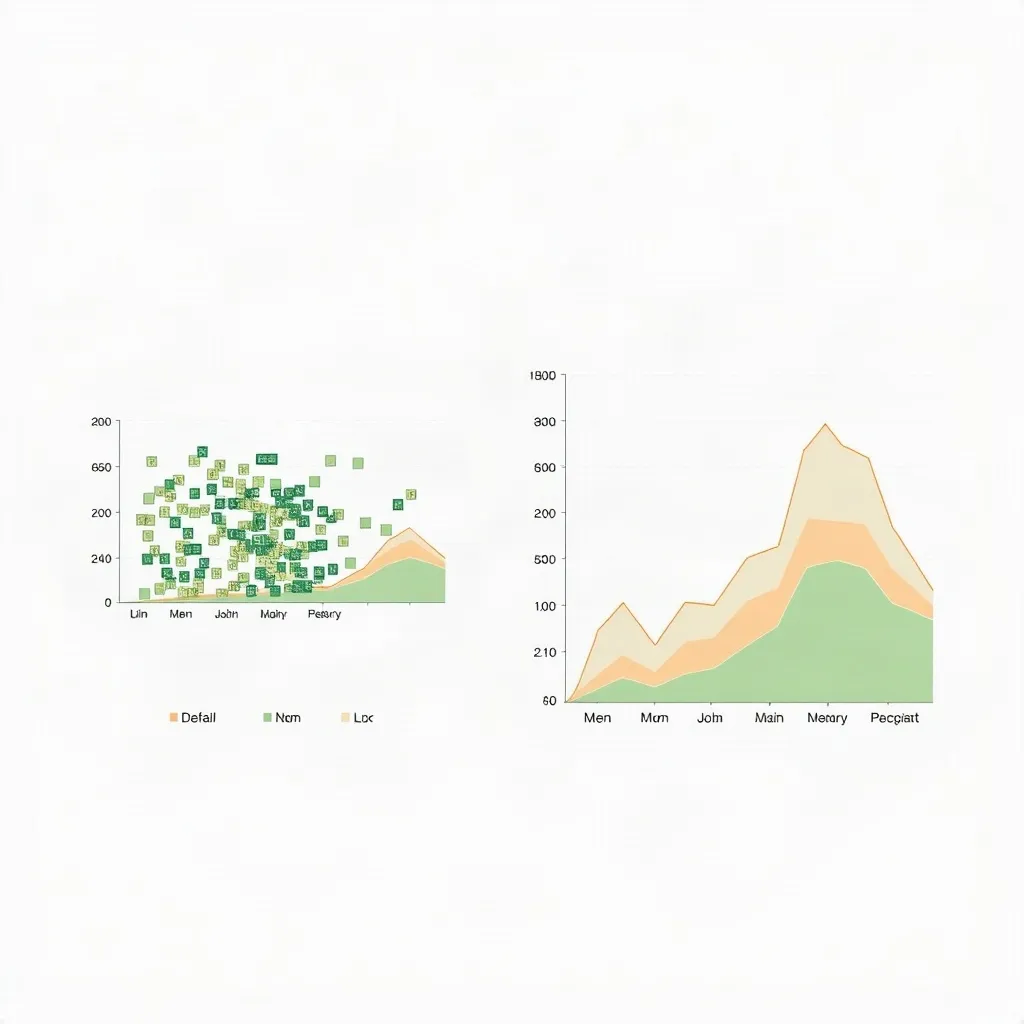
Comparación de una misma figura exportada con configuración por defecto y con parámetros ajustados
Fig. 1: la misma figura con los valores por defecto (izquierda) y con los parámetros ajustados (derecha).
«Con 300 dpi y 9 pt de tipografía el gráfico se lee a 4 metros; por debajo de 7 pt el texto se convierte en ruido y el lector abandona la figura.»Registro de observación del ensayo, jornada 3

Observaciones no previstas

Dos efectos no estaban en el diseño inicial. Eliminar los metadatos del PNG —fecha, versión de librería y ruta del archivo— redujo el peso medio por figura un 7 % sin pérdida visible en la comparación píxel a píxel. Y fijar el backend Agg en los scripts por lotes eliminó los bloqueos que aparecían al ejecutar el cuaderno en un servidor sin pantalla. Ambos ajustes quedaron incorporados al flujo de trabajo permanente.

Antes y después: seis indicadores del mismo lote

Las dos configuraciones se aplicaron sobre el mismo lote de 40 figuras y con el mismo hardware. La columna de variación se calcula sobre el valor absoluto, de modo que un descenso de peso o de tiempo se marca en negativo y una mejora de legibilidad en positivo. Ninguna cifra procede de estimaciones: todas salen del registro de ejecución del cuaderno.

El indicador más relevante no es el tiempo, sino la lectura correcta del eje: pasó de 4 a 11 personas sobre 12. Ese cambio se produjo sin aumentar el tamaño de la fuente por encima de 11 pt, solo ajustando resolución, contraste y número de series por gráfico.

Informe impreso con las figuras generadas por el cuaderno de Python y la tabla de resultados
Fig. 2: informe final con las 40 figuras exportadas y la tabla de control de indicadores.
Comparativa de indicadores antes y después del ajuste de parámetros
Indicador Configuración base Configuración ajustada Variación
Tiempo total de generación 3 min 10 s 1 min 24 s −56 %
Peso del informe entregado 38 MB 11 MB −71 %
Lectura correcta del eje Y en proyección 4 de 12 personas 11 de 12 personas +175 %
Contraste mínimo trazo / fondo 1,8 : 1 3,4 : 1 +89 %
Figuras con el eje Y truncado 6 0 −6
Errores detectados en revisión manual 9 2 −78 %

Lista de verificación antes de publicar una figura

Esta lista resume los controles que evitaron la mayoría de los errores del ensayo. Se aplica antes de cada entrega y no depende del tipo de gráfico: sirve igual para una línea temporal, un diagrama de dispersión o una matriz de correlación. En las pruebas, seguirla redujo los errores de revisión de 9 a 2 por lote.

  1. Comprobar que el tamaño de la figura coincide con el tamaño final de publicación, en pulgadas y no en píxeles.
  2. Exportar a 300 dpi si el destino es impresión o PDF; a 150 dpi si el destino es pantalla.
  3. Verificar que ningún texto del archivo final baja de 8 pt.
  4. Revisar el contraste de cada serie contra el fondo con un medidor, sin fiarse de la vista previa.
  5. Confirmar que la paleta se distingue en escala de grises y con simulación de daltonismo.
  6. Comprobar que el eje Y no está truncado y que las unidades aparecen en la etiqueta.
  7. Reproducir la figura desde el script guardado, nunca desde una sesión interactiva sin guardar.

Qué se descartó y por qué

Se descartó el uso de degradados como relleno de área: en proyección se confunden con el fondo y no aportan información adicional sobre la magnitud. También se descartaron las etiquetas de valor sobre cada punto cuando el gráfico supera las 20 observaciones, porque se solapan y obligan a reducir la fuente por debajo del mínimo legible.

Los ejes dobles se mantuvieron solo en los tres casos en que las dos magnitudes comparten unidad de referencia. En el resto se separó cada serie en su propio panel, lo que aumentó la altura del gráfico pero eliminó las lecturas erróneas de escala. El criterio quedó documentado en el diario técnico junto al resto de reglas del equipo.

Si necesitas aplicar esta lista a un conjunto de datos propio, en la página de trabajos de análisis de datos hay entregas completas con su configuración de exportación indicada figura por figura.

Conclusión del ensayo

La configuración por defecto de Matplotlib produce gráficos correctos para explorar datos y gráficos insuficientes para comunicar resultados. Los cuatro indicadores medidos mejoraron de forma simultánea al fijar resolución, tamaño, tipografía, paleta y backend de render, sin rehacer ninguna figura desde cero. El ajuste completo se aplica en una función de exportación de 30 líneas que el equipo reutiliza en todos los cuadernos.

El resultado más útil no es el ahorro de tiempo, sino la trazabilidad: cada figura se puede regenerar con los mismos parámetros meses después y obtener un archivo idéntico. Eso es lo que permite auditar un informe y defender una cifra ante un tercero. La misma lógica de control se aplica en el ensayo de análisis predictivo con Python, donde además se mide la estabilidad del modelo entre ejecuciones.

Los scripts, las tablas de medición y la función de exportación quedan disponibles para quien quiera replicar la prueba con sus propios datos.